企業知識庫(Enterprise Knowledge Base)是集中整理企業內部文件、規章、流程與經驗,讓員工在權限範圍內查詢與取用的知識系統。生成式 AI 出現後,企業知識庫的角色也從「存放文件的地方」,轉變成「直接回答問題的地方」。
許多企業已經用 RAG 做過知識庫的概念驗證(POC):把文件匯入後,Demo 時回答得很順。但要推到全公司時,卻卡在「誰能問到什麼」「答案依據是哪一份文件」「出事了查不查得到」這些問題上。企業要的不是更多 AI Demo,而是可以被信任、被管理、被持續使用的知識基礎建設。
本文依序說明企業知識庫是什麼、一般 RAG 知識庫在企業裡會遇到哪三個缺口、企業級知識庫該具備的四個標準,以及建立企業知識庫的四個步驟。
企業知識庫是什麼?跟知識管理系統、AI 知識庫有什麼關係
知識管理(Knowledge Management,簡稱 KM)是企業有系統地收集、整理、分享與運用知識的做法。支撐這件事的系統稱為知識管理系統(Knowledge Management System,簡稱 KMS),而企業知識庫就是其中存放與提供知識的核心。
傳統的知識庫系統靠資料夾分類與關鍵字搜尋:使用者輸入關鍵字,系統回傳一串可能相關的文件,閱讀、判斷與拼湊答案仍由人自己完成。AI 知識庫則是在知識庫上加入生成式 AI,理解提問的意思,跨多份文件整理出一段附來源的答案。
企業需要知識庫,往往不是文件太少,而是三個狀況同時存在:知識散在雲端硬碟、郵件、工單與各部門系統裡;關鍵經驗留在資深同仁腦中,人員異動就跟著流失;同一個問題問不同人,得到不同答案,事後也查不到依據。企業知識庫要解決的,是讓答案一致、有依據,而且不會因為誰離開就消失。
現在多數 AI 知識庫都建立在 RAG 架構上。但同樣叫做 RAG 知識庫,能不能交給全公司使用,差別很大。
一般 RAG 知識庫在企業裡會遇到的三個缺口
RAG(Retrieval-Augmented Generation,檢索增強生成)是讓 AI 先從指定資料中找出相關內容,再依據這些內容作答的技術。常見的 RAG 知識庫做法,是把文件切成段落、轉成向量,提問時找出語意最接近的段落交給模型。這套流程在 POC 階段很好用,推到全公司時則會出現三個缺口。
1. 找不準:只靠語意相似度,專有名詞常落空
向量搜尋擅長找「意思接近」的內容,但企業裡很多問題靠的是字面精準的詞,例如產品型號、專案代號或內部縮寫。只靠語意相似度,這類專有名詞常常找不到正確的段落,後面的模型再強也答不對。
2. 證不了:答案沒有來源,查無依據也硬答
答案沒有標註引用的文件與段落,使用者就無從查證。更麻煩的是,當知識庫裡根本沒有相關資料,模型仍可能用同樣肯定的語氣生成一個看似合理的答案,也就是 AI 幻覺。
3. 管不住:權限只管到登入,管不到能問什麼
很多自建的 RAG 知識庫只控管「誰能登入」,沒有控管「登入後能問到什麼」。只要文件被匯入索引,能登入的人就可能問出其他部門的合約、人事或財務內容。
這三個缺口在 POC 階段不明顯,因為測試資料少、使用者少。一旦擴大到全公司,資料來源變多、使用者角色變複雜,三個問題就會同時浮現。
常見自建 RAG 知識庫與企業知識庫的差異
除了三個缺口,兩者在資料來源、稽核與部署上也不同。下表左欄是常見的自建 RAG 做法,右欄以 ACROSS AIKM 為例。
| 比較面向 | 常見自建 RAG 做法 | 企業知識庫(ACROSS AI KM) |
|---|---|---|
| 資料來源 | 手動上傳少數格式 | 13 種文件格式加 30+ 企業內容連接器,原系統權限一起同步 |
| 檢索方式 | 只靠向量相似度 | 語意與關鍵字一起找,再重新排序 |
| 回答依據 | 找不到也照樣回答 | 答案附來源,查無依據就不回答 |
| 權限控管 | 只管到誰能登入 | 檢索前先過濾,加上文件層級權限,兩道防線 |
| 稽核合規 | 缺少完整紀錄 | 稽核日誌、異動留痕,資料加密儲存,符合高合規要求 |
| 部署選擇 | 綁定單一雲端或模型 | 雲端、地端或混合部署,模型可替換 |
兩者的差距不只在找不找得到,而在資料怎麼進、誰能查、如何答,以及每個答案如何證明。
還在用自建的 RAG 知識庫撐全公司的需求?立即諮詢,我們幫你盤點權限與稽核的缺口!

企業知識庫的四個標準:ACROSS AIKM 怎麼做到
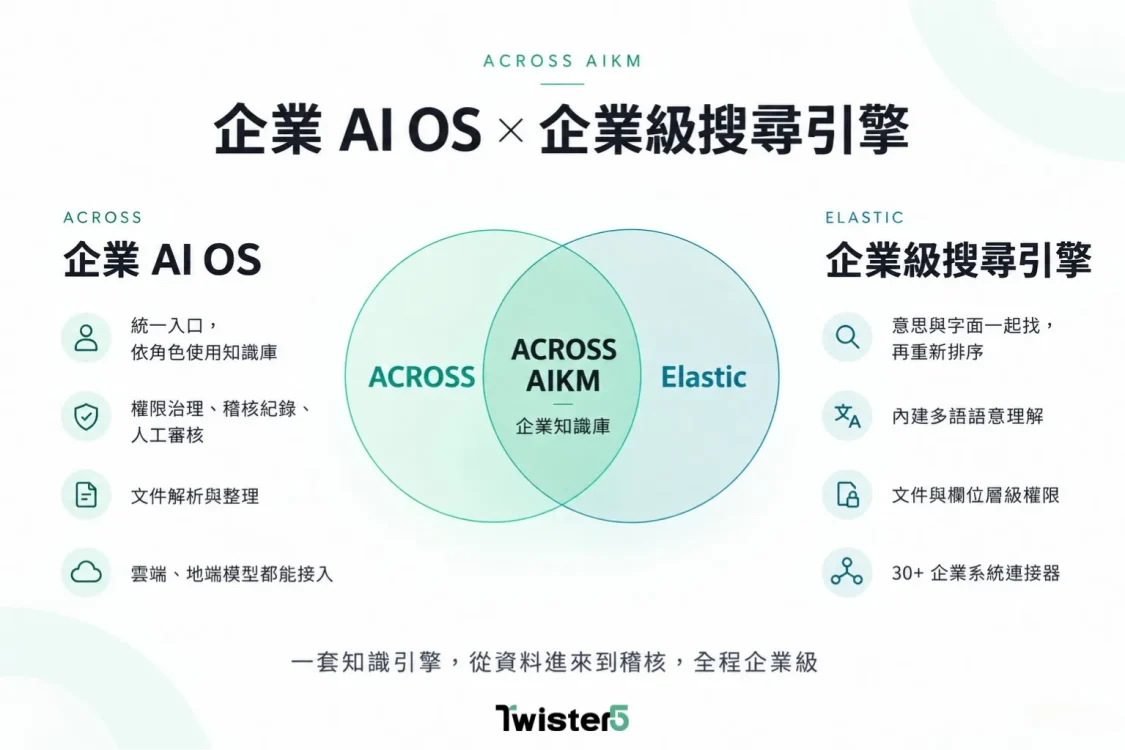
企業級的知識庫要同時做到四件事:找得到、答得準、守得住、查得到。ACROSS AIKM 是 Twister5 極風雲創 ACROSS 企業 AI OS 的資料與知識層,由兩個部分結合而成:ACROSS 負責統一入口、權限治理與模型接入;Elastic Enterprise 搜尋引擎負責檢索、語意理解、引擎層權限與企業系統連接。兩者結合,讓同一套知識引擎從資料進來、檢索、回答到稽核,全程都是企業級。
1. 找得到:企業知識一次收進來
只有真正進入知識庫的內容,才有機會被查詢與引用。ACROSS AIKM 從三個方向把企業知識收進來:
- 13 種文件格式:Office 文件、PDF 掃描檔與圖片都能收進來,掃描頁與圖片裡的文字也能被讀出來。
- 30+ 企業內容連接器:SharePoint、Teams、Outlook、Jira 等協作、通訊與業務系統定期自動同步,並帶入原系統的權限。這些協作工具是知識的來源,導入企業知識庫不需要換掉它們。
- 系統紀錄也是企業知識:資安設備、雲端平台與網路設備的運作紀錄和事件,也能收進同一個知識庫,統一格式後,使用者依權限用日常語言查詢。文件、業務資料與系統事件,可以在同一個地方查。
📌 選擇前該問:連接器同步資料時,會一併帶入原系統的權限嗎?
2. 答得準:找得準,也說得出依據
ACROSS AIKM 同時用「意思」和「字面」兩種方式搜尋,合併結果後再重新排序,最後補上完整段落給 AI 閱讀。產品型號、內部縮寫這類專有名詞,也能被準確找到。這套檢索由 Elastic 提供。
找到資料之後,回答有三條規則:
- 答案標出引用的文件與段落,使用者可以回頭查證
- 查不到依據就直接回覆查無資料,不讓 AI 自己編答案
- 不同知識庫的內容彼此隔離,不會互相混用
細節可參考《AI幻覺不是Prompt寫不好》。
📌 選擇前該問:查不到依據時,是系統直接擋下,還是靠提示詞請 AI 說不知道?
3. 守得住:雙重權限防線
AI 知識庫最大的風險,是「誰問都答得出來」。ACROSS AIKM 用兩道防線,讓 AI 只回答使用者有權看的內容:
| 防線 | 做法 |
|---|---|
| 第一道:搜尋之前先過濾 | 依公司、部門與職務角色(RBAC)決定每個人能問的範圍,不同部門的知識彼此隔離 |
| 第二道:搜尋引擎再守一道 | 權限細到每一份文件、每一個欄位;同步 SharePoint 等原系統權限;直接沿用企業現有的帳號與單一登入系統 |
因為權限在搜尋之前就生效,AI 從一開始就接觸不到超出權限的內容,而不是事後才把不該出現的答案過濾掉。
📌 選擇前該問:權限能細到每一份文件、每一個欄位嗎?還是只能控管到整個知識庫?
4. 查得到:合規與稽核有跡可循
稽核時要回答的不只是「答案對不對」,還有「誰在什麼時候查了什麼」。ACROSS AIKM 提供:
- 完整紀錄:每一次查詢與存取都留下稽核日誌與追蹤紀錄
- 異動留痕:文件由誰建立、何時建立、最後由誰修改,都有紀錄
- 合規加密:靜態資料加密儲存,符合高合規要求,滿足高合規產業的要求
- 備援與封存:支援異地備援,歷史資料封存後仍可查詢
知識資料與 AI 模型分開管理,日後要更換模型或重建索引,都保有彈性。
📌 選擇前該問:出事時,能查到誰在什麼時候問了什麼、存取了哪些內容嗎?
知識庫不是一套單獨的工具
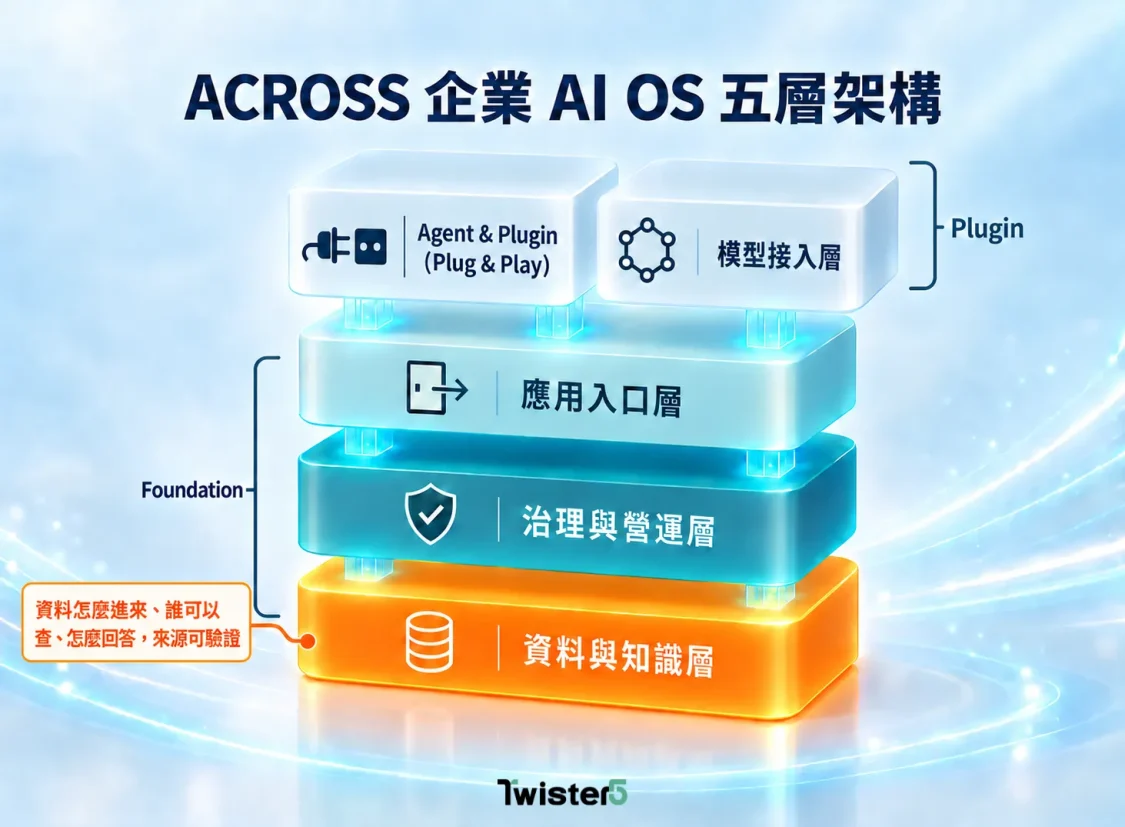
ACROSS AIKM 是 ACROSS 五層架構中的資料與知識層,跟其他幾層在同一個平台上運作:員工從統一 AI 入口依角色使用知識庫,權限、稽核與人工審核由治理營運層管理,雲端或地端的 AI 模型都能接入。知識庫不需要另外拼裝權限與稽核,一開始就在企業的治理架構裡。
如何建立企業知識庫?四個步驟
建立企業 AI 知識庫,不建議一開始就涵蓋全公司。先挑一個經常被重複詢問的場景,照以下四個步驟完成一個小而完整的範圍,再依部門擴大。
1. 盤點與整理資料
找出最常被問的主題,確認二到三個相關的資料來源。匯入前先做三件事:下架已失效的舊版文件,避免新舊版本並存;整理部門術語與縮寫;確認掃描檔與圖片能被解析。ACROSS AIKM 支援 13 種文件格式,掃描頁與圖片掃描頁與圖片裡的文字也能被 AI 讀出來。
2. 對應權限
先決定公司知識庫與部門知識庫怎麼切分,以及各角色能問到哪些內容。再確認資料從來源系統進入知識庫時,原本的權限是否一併帶入。權限設計放在上線之前,而不是上線後才補強。
3. 用真實題庫驗證
搜集多則員工真實會問的問題當驗收題庫,逐題檢查三件事:答案有沒有附上正確來源、查不到依據時是否直接回覆查無資料、用不同角色的帳號提問時會不會問到不該看的內容。
4. 維護與回饋
把系統答不出來的問題整理成待補充清單,建立文件維護與權限覆核的固定機制。ACROSS AIKM 的異動留痕會記錄建立者與最後編輯者,維護責任有跡可循。各階段的導入細節,可以參考《AI KM(AI 知識庫)是什麼?》中的導入三階段。
企業知識庫常見問題FAQ
企業知識庫至少應具備六項功能:支援多種文件格式與企業系統連接器、語意與關鍵字混合檢索、答案附來源、查無依據時不回答、文件層級的權限控管,以及完整的稽核紀錄。受監管產業還需要確認是否支援地端部署與加密合規。
建議依四個標準比較:找得到(能否接入各系統並同步原有權限)、答得準(是否附來源、查無依據時是否直接不回答)、守得住(權限能否細到文件與欄位)、查得到(是否有完整稽核紀錄)。需要跨部門、跨系統使用,或有地端部署與合規需求的企業,可以考慮像 ACROSS AIKM 這類企業級知識平台。
差在找到資料之後的事。一般 RAG 知識庫常只靠向量相似度檢索,權限只管到登入;企業知識庫還要做到語意與關鍵字混合檢索、答案附來源、查無依據不回答、檢索前權限過濾,以及完整的稽核紀錄。
員工可以直接用提問取得附來源的答案,不必自己翻找與拼湊多份文件;同一個問題得到一致的答案,每個答案都能回溯原文查證;關鍵經驗留在知識庫裡,不會因為人員異動而流失,新人也能自行查詢上手。
可以。ACROSS AIKM 支援雲端、地端或混合部署,模型可替換,資料不能外流的企業可以把知識庫建在自己的環境裡。知識資料與 AI 模型分開管理,日後更換模型也保有彈性。地端與雲端 AI 的選擇考量,可參考《地端AI是什麼?》。
傳統 KM 靠關鍵字搜尋,回傳一串文件清單;導入 AI 的企業知識庫理解提問語意,直接給出附來源的答案。更完整的比較可參考《AI KM(AI 知識庫)是什麼?與傳統 KM 的差異》。
企業知識庫的關鍵,不只在找得到
RAG 知識庫的 POC 做得出來並不難,難的是推到全公司之後,仍然可信、可管、可查。評估企業知識庫時,可以用四個標準檢視:
- 找得到:文件、協作工具與系統事件都收得進來,權限一起同步
- 答得準:混合檢索加重新排序,答案附來源,查無就不硬答
- 守得住:檢索前過濾加文件與欄位層級權限,雙重防線
- 查得到:稽核日誌、異動留痕,資料加密儲存,符合高合規要求
Twister5 極風雲創以資安起家,ACROSS 將權限與稽核視為知識庫設計的起點,而不是上線後才補強的項目,讓企業知識成為可信任的 AI 資產。想了解知識庫在企業 AI 基礎建設中的位置,可參考《企業AI導入怎麼做?五層架構打造企業AI基礎建設指南》。
你的企業知識庫,離全公司上線還差哪一步?立即預約 Demo!